كيفية إضافة ميزة ذكاء اصطناعي إلى منتج SaaS الخاص بك دون إعادة بناء المنتج
إذا وضعت استدعاءات النموذج داخل تطبيقك الأساسي، فإن استجابة بطيئة واحدة قد تعطله لجميع المستخدمين. استخدام خدمة ذكاء اصطناعي منفصلة تتغذى من طابور (queue) يحافظ على سرعة منتجك، ويفصل بيانات كل عميل، ويتيح لك معرفة التكلفة لكل إجراء قبل الإطلاق.
أسرع طريقة لتعطيل منتج SaaS يعمل بكفاءة هي استدعاء نموذج لغوي من داخل تطبيق الويب الرئيسي الخاص بك. استجابة النموذج (model response) قد تستغرق عدة ثوانٍ. خلال هذا الوقت، يبقى خادم الويب (web server worker) الذي يُفترض أن يحمّل لوحات المعلومات معطلاً. مع زيادة عدد المستخدمين، ستتباطأ صفحة تسجيل الدخول بسبب ميزة لم يستخدمها معظمهم أصلاً.
لست بحاجة لإعادة بناء المنتج لحل هذه المشكلة. ضع عمل الذكاء الاصطناعي في خدمة منفصلة واربطها بمنتجك عبر طابور (queue). سيستمر تطبيقك الأساسي في أداء ما يتقنه.
هذا المقال مخصص لمنتج يعمل بالفعل. إذا كنت تبدأ من الصفر، فابدأ بـ حزمة التقنيات التي نوصي بها لمنتج ذكاء اصطناعي جديد بدلاً من ذلك. عُد إلى هنا عندما يكون لديك عملاء تحتاج لحمايتهم.
لماذا لا يجب أن تكون استدعاءات النموذج في خادم الويب الخاص بك
استعلام قاعدة البيانات المعتاد يعود في عشرات الميلي ثانية. بينما يستغرق إنشاء النموذج (model generation) ثوانٍ، والإجابة الطويلة قد تستغرق وقتاً أطول بكثير. يعتمد الوقت على طول الموجّه (prompt)، وطول المخرجات، ومدى انشغال مزود الخدمة.
أطر عمل الويب مثل Rails و Django و Express تتعامل مع عدد محدود من الطلبات في وقت واحد. كل استدعاء بطيء للنموذج يحجز أحد هذه المسارات طوال مدته. عندما ينقر العديد من المستخدمين على "إنشاء تقرير" معاً، تنفد هذه المسارات. والمستخدمون الذين أرادوا فقط تسجيل الدخول سينتظرون خلفهم.
المشكلة الثانية هي الفشل. مزودو النماذج يفرضون قيوداً على معدل الطلبات (rate limits)، وقد تنتهي مهلة الاتصال (timeouts) أو تحدث انقطاعات. إذا كان الاستدعاء داخل طلب الويب الخاص بالمستخدم، فإن هذا الخطأ يظهر مباشرة للمستخدم. سيقوم فريقك بعد ذلك بزيادة مهلة الاتصال وإضافة محاولات إعادة (retries) في الكود الأساسي. وخلال بضعة أشهر، ستجد الموجّهات (prompts) مبرمجة بشكل ثابت (hardcoded) في الـ controllers ولن يرغب أحد في لمسها.
المشكلة الثالثة هي الأدوات. معظم أطر عمل الوكيل (agent frameworks)، ومكتبات التقييم، وعملاء قاعدة بيانات المتجهات (vector database) مبنية أساساً بلغة Python. استخدامها من تطبيق monolith مبني بـ PHP أو Ruby يعني كتابة واجهات (wrappers) وصيانتها بنفسك.
إذا اضطررت لزيادة مهلة الطلب (request timeout) في تطبيقك الرئيسي فقط لتتمكن ميزة ذكاء اصطناعي من الانتهاء، فهذا يعني أن مشكلة الحمل الزائد (overload) قد بدأت بالفعل.
نمط الـ sidecar: خدمة منفصلة تتغذى من طابور (queue)
الحل هو خدمة ذكاء اصطناعي مستقلة تعمل بجانب منتجك. يسمي المهندسون هذا النمط بـ sidecar. تطبيقك الأساسي يحتفظ بمنطق الأعمال (business logic)، والمصادقة، ونظام السجلات الأساسي. بينما يتولى الـ sidecar الموجّهات (prompts)، والاسترجاع (retrieval)، واستدعاءات النموذج (model calls)، وكل ما هو بطيء أو غير متوقع.
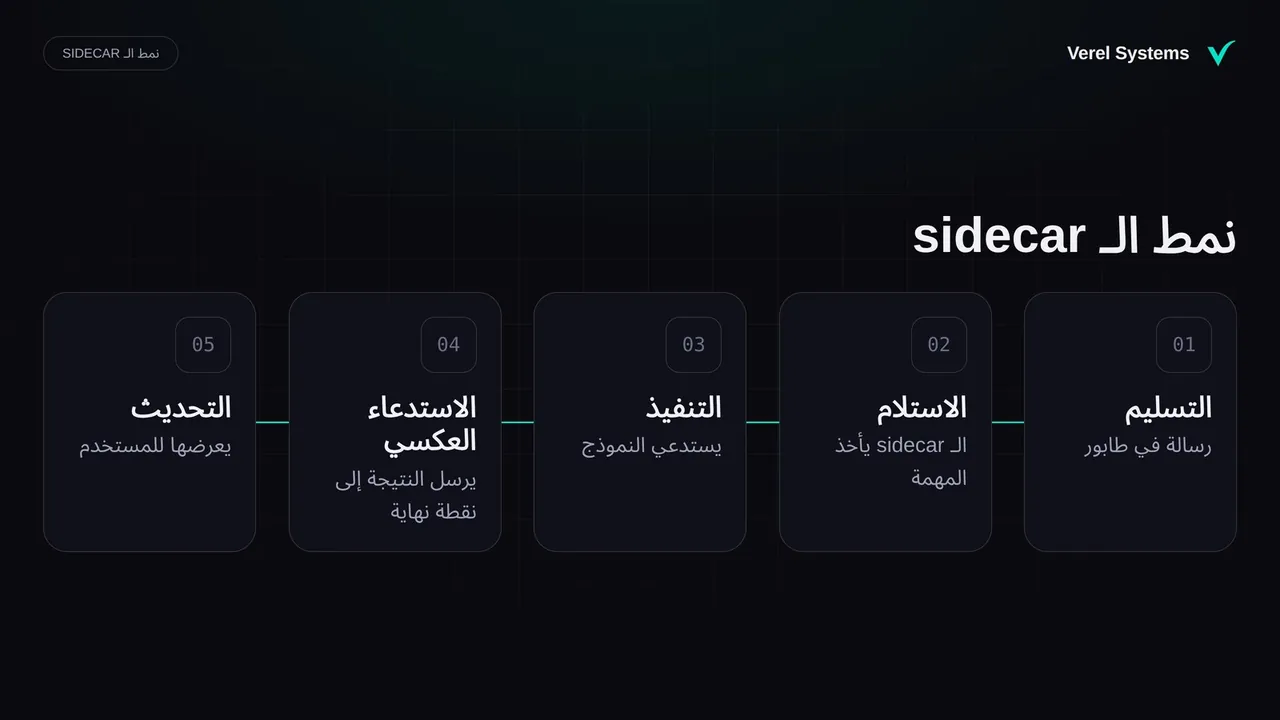
إليك سير العمل لميزة نموذجية، مثل "صياغة رد على تذكرة الدعم هذه":
- ▸المشغّل (Trigger). ينقر المستخدم على الزر. يسجل تطبيقك المهمة (job) ويُرجع حالة "جاري العمل" فوراً.
- ▸التسليم (Handoff). يضع التطبيق رسالة صغيرة في طابور (queue)، مثل Redis أو RabbitMQ أو AWS SQS. تحتوي الرسالة على معرّف التذكرة، ومعرّف المستأجر (tenant ID)، ومعرّف المهمة (job ID).
- ▸الاستلام (Pickup). يأخذ الـ sidecar المهمة من الطابور. وهو يعمل على بنية تحتية مخصصة للمهام الطويلة، منفصلة عن طبقة الويب الخاصة بك.
- ▸التنفيذ (Execution). يجلب السياق الذي يحتاجه، ويستدعي النموذج (model)، ويستخدم أي أدوات، ويتعامل مع محاولات الإعادة (retries) الخاصة به إذا فرض مزود الخدمة قيوداً على معدل الطلبات.
- ▸الاستدعاء العكسي (Callback). يرسل النتيجة إلى نقطة نهاية (endpoint) داخلية في تطبيقك، مع معرّف المهمة.
- ▸التحديث (Update). يحفظ تطبيقك النتيجة ويعرضها للمستخدم عبر دفع WebSocket أو الاستعلام المتكرر (polling).
النتيجة العملية هي الاحتواء (containment). إذا تعطل الـ sidecar، أو تباطأ، أو فقد الاتصال بمزود النموذج، فإن منتجك الرئيسي يستمر في خدمة الزيارات. تتراجع الميزة فقط بينما لا يتأثر باقي المنتج.
ثلاثة تفاصيل تحدد ما إذا كان هذا سيصمد في بيئة الإنتاج (production):
- ▸مهام غير متكررة التأثير (Idempotent jobs). يمكن للطوابير تسليم نفس الرسالة أكثر من مرة. اربط كل مهمة بمعرفها (ID) حتى لا تؤدي محاولة الإعادة إلى إرسال ردين.
- ▸طابور الرسائل الميتة (Dead-letter queue). بعد عدد محدد من المحاولات الفاشلة، انقل المهمة جانباً وضع علامة "فشلت" في واجهة المستخدم. لا شيء يجب أن يعيد المحاولة إلى الأبد.
- ▸حصص لكل مستأجر في الـ sidecar. قيود معدل الطلبات وميزانيات التوكنز (tokens) تكون في مكان واحد. لا يمكن لحساب واحد ثقيل أن يستنزف هامش ربحك أو يبطئ العملاء الآخرين.
مهندسوك الحاليون سيتعاملون مع الـ sidecar كما يتعاملون مع Stripe أو Twilio: طلب محدد، استدعاء عكسي (callback) محدد، ورموز خطأ موثقة. لا يحتاجون لأن يصبحوا خبراء في الموجّهات (prompts) أو التضمين (embedding) لمواصلة تطوير المنتج الأساسي.
فصل بيانات كل عميل
سيسأل مشترو الشركات (Enterprise buyers) سؤالاً واحداً قبل أي شيء آخر. كيف تمنع بيانات العميل "أ" من الظهور في إجابات العميل "ب"؟ تحتاج إلى إجابة معمارية (architectural) لذلك، لأن وثيقة السياسة وحدها لن ترضيهم.
هناك اختصاران يسببان معظم المشاكل. الأول هو إعطاء الذكاء الاصطناعي وصولاً مباشراً عبر SQL إلى قاعدة بيانات الإنتاج الخاصة بك. والثاني هو تحميل سجل المستخدم بالكامل في كل موجّه (prompt). الأول يمثل ثغرة أمنية. والثاني يمثل مشكلة تكلفة تؤدي غالباً إلى إجابات أسوأ.
التصميم الأكثر أماناً له قاعدتان.
توكنز محددة النطاق، وليس وصولاً لقاعدة البيانات. مع كل مهمة، يتلقى الـ sidecar توكن قصير العمر يقتصر على مستأجر (tenant) واحد. عندما يحتاج إلى بيانات، فإنه يستدعي الـ API الداخلي لتطبيقك باستخدام هذا التوكن. يظل تطبيقك هو المصدر الوحيد للحقيقة ويطبق قواعد الوصول التي يفرضها بالفعل. إذا طلب الـ sidecar شيئاً خارج نطاق هذا المستأجر، يتم رفض الطلب.
فلتر صارم للمستأجر في كل عملية بحث. بعض الميزات تبحث في المستندات المرفوعة، وهو ما يُعرف بالتوليد المعزز بالاسترجاع (RAG). بالنسبة لهذه الميزات، يحتفظ الـ sidecar بفهرس متجهات (vector index) خاص به في قاعدة بيانات المتجهات مثل Qdrant أو pgvector. كل مقطع (chunk) مخزن يحمل حقلاً باسم tenant_id. يتم فلترة كل استعلام بواسطة الـ tenant_id النشط قبل تشغيله. يأتي هذا الفلتر من المهمة (job)، وليس من النموذج أو نص المستخدم أبداً.
هذا يمنحك دليلاً واضحاً للمراجعة الأمنية. لا تمتلك خدمة الذكاء الاصطناعي بيانات اعتماد مباشرة لقاعدة البيانات. إنها تعمل فقط من خلال توكنز محددة النطاق، ولا يمكن لعمليات البحث الخاصة بها إرجاع مستندات مؤسسة أخرى. هذا يساعد في تقييم SOC 2. كما يساعد في مراجعة حماية البيانات بموجب قوانين مثل المرسوم بقانون اتحادي رقم 45 لسنة 2021 في الإمارات أو نظام حماية البيانات الشخصية (PDPL) في السعودية. قائمة التحقق من الامتثال لـ PDPL لأنظمة الذكاء الاصطناعي الخاصة بنا تسرد ما سيطلب المراجع رؤيته. التصميم لا يجعلك ممتثلاً بحد ذاته، ولكنه يجعل إجابة العزل قصيرة وقابلة للتحقق.
اختيار نمط التكامل
الطريقة التي يتحدث بها تطبيقك وخدمة الذكاء الاصطناعي مع بعضهما البعض تحدد تجربة المستخدم والتكلفة والمخاطر. الجدول أدناه يوضح القرار الذي يجب على معظم الفرق اتخاذه أولاً.
| نمط التكامل | الانتظار المعتاد للمستخدم | الخطر على المنتج الأساسي | أفضل استخدام لـ |
|---|---|---|---|
| استدعاء متزامن (Synchronous call) | <2 ثانية | عالٍ | التصنيف، توجيه النوايا، التسميات القصيرة |
| طابور غير متزامن + استدعاء عكسي (sidecar) | تقريباً 5 إلى 30 ثانية | منخفض، معزول | صياغة الردود، الملخصات، إنشاء التقارير |
| مهمة وكيل (agent) طويلة الأمد | دقائق | منخفض، معزول | البحث متعدد الخطوات، استخراج المستندات، مسارات العمل التي تستخدم الأدوات |
استدعاء متزامن (Synchronous call). استخدم هذا فقط مع النماذج الصغيرة والسريعة أو المصنفات المتخصصة، للمهام التي تنتهي بشكل موثوق في أقل من ثانيتين. تحديد الطابور الذي تنتمي إليه الرسالة هو مثال جيد. لا تستخدمه لعمليات التوليد (generation).
طابور غير متزامن واستدعاء عكسي. هذا هو الخيار الافتراضي الصحيح لمعظم ميزات الذكاء الاصطناعي في SaaS. يرى المستخدمون مؤشر تحميل أو حالة تقدم. يمكنك بعد ذلك استخدام نماذج أكبر من عائلات Claude أو GPT أو Gemini دون أن تؤدي الاستجابات البطيئة إلى تعطيل خوادم الويب الخاصة بك. إذا أراد المستخدمون مشاهدة النص وهو يظهر، قم بالبث (stream) من الـ sidecar إلى المتصفح. تظل خوادم الويب الخاصة بك خارج هذا المسار.
مهمة وكيل (agent) طويلة الأمد. هذا مخصص للميزات حيث يستخدم الذكاء الاصطناعي أدوات، أو يتحقق من عمله، أو ينفذ عدة خطوات. يبدأ المستخدم المهمة ويتلقى إشعاراً عند انتهائها. يحتاج الـ sidecar إلى مخزن حالة (state store) خاص به، عادةً PostgreSQL، حتى تتمكن المهمة من الاستئناف بعد إعادة التشغيل بدلاً من البدء من جديد.
حساب تكلفة الميزة قبل بنائها
احسب التكلفة لكل إجراء (cost per action) قبل تخصيص وقت الهندسة. تنقسم تكاليف التشغيل إلى جزأين. الاستنتاج (Inference) هو ما يفرضه مزود النموذج (model) لكل توكن. والحوسبة (Compute) هي البنية التحتية التي تشغل الـ sidecar.
معادلة الاستنتاج بسيطة.
</>View technical implementation · عرض التفاصيل التقنية
Monthly inference cost = users × actions per user per day × 30
                         × (input tokens × input price + output tokens × output price) ÷ 1,000,000
الأسعار هنا معروضة لكل مليون توكن. إليك مثال عملي، وكل رقم فيه توضيحي. تقع الأسعار في نطاق الفئات الصغيرة والسريعة المدرجة في صفحات أسعار OpenAI و Anthropic وقت كتابة هذا المقال. تحقق من الأسعار الحالية قبل وضع ميزانيتك، لأنها تتغير باستمرار.
- ▸أسعار توضيحية: 0.15 دولار لكل مليون توكن إدخال، 0.60 دولار لكل مليون توكن إخراج.
- ▸1,000 مستخدم نشط، يستخدم كل منهم الميزة 5 مرات في اليوم: 5,000 إجراء يومياً.
- ▸يرسل كل إجراء حوالي 3,000 توكن إدخال (التذكرة بالإضافة إلى السجل) ويعيد حوالي 500 توكن إخراج.
الحسابات:
- ▸الإدخال: 5,000 × 3,000 = 15,000,000 توكن يومياً. 15 × 0.15 دولار = 2.25 دولار يومياً.
- ▸الإخراج: 5,000 × 500 = 2,500,000 توكن يومياً. 2.5 × 0.60 دولار = 1.50 دولار يومياً.
- ▸إجمالي الاستنتاج: 3.75 دولار يومياً، أي حوالي 112.50 دولار شهرياً. وهذا يعادل 0.00075 دولار لكل إجراء.
بالنسبة للحوسبة، افترض 40 إلى 100 دولار شهرياً بهذا الحجم على المنصات الخالية من الخوادم (serverless) التي تحاسب بالثانية، مثل Modal أو Railway. تعامل مع هذا كتقدير وتأكد منه مقابل نمط الزيارات الخاص بك. يصل إجمالي تكلفة التشغيل إلى حوالي 150 إلى 215 دولار شهرياً لـ 5,000 إجراء يومياً.
هناك شيئان يغيران هذا الرقم أكثر من اختيار النموذج. الأول، حجم السياق (context size): مضاعفة السجل الذي ترسله يضاعف تقريباً تكلفة الإدخال. الثاني، محاولات الإعادة (retries) والحلقات غير المنضبطة (runaway loops)، والتي يمكن أن تضاعف الفاتورة دون أن يلاحظ أي مستخدم. تمت تغطية كلاهما في مقالنا حول محاولات الإعادة، ونمو السياق، وعبء التقييم. الميزانيات المخصصة لكل مستأجر في الـ sidecar هي وسيلة التحكم الخاصة بك لكلا الأمرين.
ثم قارن التكلفة بالإيرادات وفقاً لظروفك. قد تدعم الميزة زيادة في السعر بمقدار X لكل مستخدم، أو تقلل من معدل الإلغاء (churn) بمقدار Y حساب شهرياً. ضع هذه الأرقام بجانب التكلفة الشهرية أعلاه. إذا كانت النسبة غير مقنعة على الورق، فلن تتحسن بعد الإطلاق. عندما تقتنع بها، فإن المهمة التالية هي تحويل التكلفة لكل إجراء إلى سعر خطة، وهو ما له مقال خاص به.
الأسئلة الشائعة
كم من الوقت يستغرق إضافة sidecar إلى منتج حالي؟ بالنسبة لميزة واحدة محددة جيداً، خطط لأسابيع بدلاً من أشهر. يذهب معظم الجهد في الاتفاق على العقد (contract) بين تطبيقك والـ sidecar. ويذهب الباقي في ضبط الاسترجاع (retrieval) والموجّهات (prompts) حتى تلبي الدقة معاييرك. البنية التحتية عادة ما تكون الجزء الأصغر.
ماذا يحدث عندما يواجه مزود النموذج انقطاعاً في الخدمة؟ يستمر منتجك الأساسي في العمل. تعود المهام الفاشلة إلى الطابور مع زيادة التأخير بين المحاولات. بعد حد معين، تنتقل إلى طابور الرسائل الميتة (dead-letter queue) وتظهر كفاشلة في واجهة المستخدم الخاصة بك. يمكنك أيضاً تكوين الـ sidecar للانتقال التلقائي (failover) إلى مزود ثانٍ، على سبيل المثال من نموذج GPT إلى نموذج Claude.
كيف نمنع الذكاء الاصطناعي من اختراع بيانات لا يمتلكها؟
قلل ما يمكنه رؤيته وامنحه طريقة للرفض. يجيب الـ sidecar فقط من البيانات المرسلة (payload) ومن البيانات التي تم جلبها من خلال الـ API محدد النطاق. عندما يكون السياق المطلوب مفقوداً، فإنه يُرجع رمزاً محدداً مثل INSUFFICIENT_CONTEXT بدلاً من التخمين. يلتقط تطبيقك هذا الرمز ويطلب من المستخدم ما هو مفقود. اختبر هذا قبل الإطلاق بحالات يكون فيها الجواب غائباً عمداً.
خطوتك التالية هي ورقة التكاليف. اكتب عدد المستخدمين، والإجراءات لكل مستخدم، والتوكنز لكل إجراء، والأسعار الحالية لمزودك، ثم قم بتشغيل المعادلة أعلاه. إذا كانت التكلفة لكل إجراء تترك لك هامش ربح، فقم ببناء الـ sidecar. وإذا لم تكن كذلك، فاعمل على حجم السياق والتسعير قبل أن تعمل على النموذج.