تقييم الوكلاء في بيئة الإنتاج: تتبع استخدام الأدوات والمسارات
تقييم الإجابة النهائية للوكيل فقط يغفل معظم الأخطاء التي تحدث. التتبع على مستوى الخطوات، وموجهات التقييم الموجهة، وبوابة التكامل المستمر (CI) تكتشف أخطاء استخدام الأدوات قبل أن تصل للعملاء. إليك مثال عملي للتتبع، وموجهات التقييم، والتكلفة.
أجاب الوكيل بأدب، واستخدم قواعد لغوية صحيحة، ولكنه كان مخطئًا. أبلغ عميل عن خصم مكرر من "يوم الثلاثاء الماضي". بحث الوكيل في النظام الصحيح ولكن بسنة خاطئة. لم يجد شيئًا وأخبر العميل بعدم وجود خصم مكرر. إذا قمت بتقييم الرسالة النهائية فقط، فإن هذه العملية ستنجح في التقييم.
الضرر يحدث عادة بين السؤال والإجابة. يختار الوكيل أداة، ويكتب مدخلاتها، ويقرأ ما يعود منها، ثم يقرر الخطوة التالية. أي من هذه الخطوات يمكن أن تفشل بصمت. وغالبًا ما تبدو الإجابة في النهاية جيدة على أي حال.
لهذا السبب، تفشل طرق التقييم المصممة لأنظمة الإجابة على الأسئلة بمجرد أن يبدأ الوكيل في اتخاذ إجراءات. وهذا أيضًا أحد الأسباب الشائعة التي تجعل مشاريع الوكلاء تتعثر بين المرحلة التجريبية وبيئة الإنتاج. استخدم العرض التجريبي عشرة أسئلة اختبار بسيطة. أما بيئة الإنتاج فتشهد آلاف العمليات يوميًا، ولا أحد يستطيع رؤية ما يحدث بداخلها. العديد من هذه العمليات تفشل في طبقة الـ API دون إثارة أي خطأ.
أخطاء الخطوات تتضاعف
إليك الحسبة الرياضية التي يجب أن تحدد ميزانية التقييم الخاصة بك. إذا نجحت كل خطوة في مسار العمل باحتمال p، فإن مسار عمل مكون من n خطوة ينجح باحتمال p أس n.
لنأخذ مسار عمل لاسترداد الأموال مكون من خمس خطوات: تصنيف الطلب، جلب سجل العميل، التحقق من سياسة الاسترداد، إصدار الاسترداد، وإرسال تأكيد. لنفترض أن كل خطوة صحيحة بنسبة 95%. هذا يبدو ممتازًا في المرحلة التجريبية.
</>View technical implementation · عرض التفاصيل التقنية
Step 1  Classify request      0.95   cumulative 95.0%
Step 2  Fetch CRM record      0.95   cumulative 90.3%
Step 3  Check refund policy   0.95   cumulative 85.7%
Step 4  Issue refund          0.95   cumulative 81.5%
Step 5  Send confirmation     0.95   cumulative 77.4%
تقريبًا عملية واحدة من كل أربع عمليات تفشل في مكان ما. أضف خطوة موافقة وخطوة تسجيل، وسبع خطوات بنسبة 95% لكل منها ستضعك تحت نسبة 70% بقليل.
يمكنك حساب تكلفة ذلك بأرقامك الخاصة:
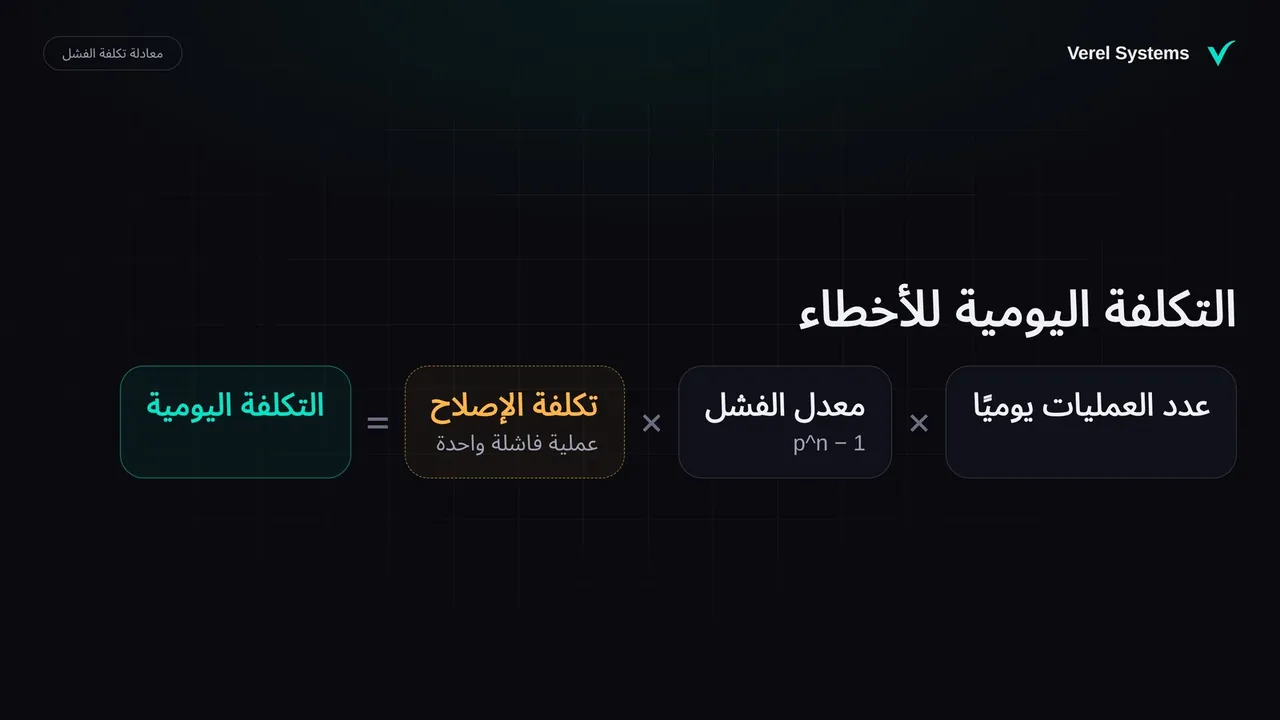
التكلفة اليومية للأخطاء = عدد العمليات يوميًا × (1 - p^n) × تكلفة إصلاح عملية فاشلة واحدة
المصطلح الأخير هو ما تقلل معظم الفرق من تقديره. إنه يغطي وقت الموظفين في التصعيد، وأي استرداد تم إصداره مرتين، والعميل الذي يغادر. ضع أرقامك الخاصة. بالنسبة لمعظم مسارات العمل، تكون النتيجة أكبر من ميزانية الذكاء الاصطناعي بأكملها.
هناك طريقتان لتحسين النتيجة: جعل كل خطوة أكثر موثوقية، أو استخدام خطوات أقل. لا يمكنك القيام بأي منهما إلا إذا كنت تستطيع رؤية الخطوة التي تفشل. وهذه هي المهمة الأساسية لتقييم المسار (trajectory evaluation).
لماذا تخفق مقاييس الإجابة النهائية في اكتشاف الأخطاء
المسار هو السجل الكامل والمرتب لعملية واحدة. يحتوي على كل استدعاء للنموذج، وكل استدعاء للأداة بمدخلاتها الدقيقة، وكل استجابة للأداة، وكل قرار بينهما. تفترض المقاييس القياسية لأنظمة الإجابة على الأسئلة تدفقًا بسيطًا: إدخال سؤال، استرجاع المستندات، إخراج إجابة. درجات الموثوقية والملاءمة في أطر عمل مثل RAGAS هي أمثلة على ذلك. الوكلاء يدخلون في حلقات تكرار، ويحاولون مرة أخرى، ويغيرون مسارهم الخاص.
تقييم الإجابة النهائية يغفل ثلاثة أنواع من الفشل.
أخطاء الأدوات الصامتة. ينجح استدعاء الأداة تقنيًا ولا يُرجع أي خطأ، لكن المدخلات كانت خاطئة. استعلام عن عقود الربع الثالث بتواريخ الربع الثاني يُرجع عقود الربع الثاني. ثم يقوم الوكيل بتلخيص المستندات الخاطئة بثقة تامة.
موثوقية للمصدر الخطأ. يسأل شخص ما عن إيرادات الربع الماضي. يستدعي الوكيل بحث الويب بينما كان ينبغي عليه استدعاء قاعدة البيانات المالية الداخلية، ولا يجد شيئًا، ويرد بأنه لا يملك صلاحية الوصول. مقياس الموثوقية يمنح هذه الإجابة درجة مثالية، لأنها تتطابق مع ما تم استرجاعه. الفشل الحقيقي كان في اختيار الأداة. والأسوأ من ذلك، أن الاستعلام ربما يكون قد ذهب إلى محرك بحث عام.
إجابة صحيحة، مسار خاطئ. يُبلغ الوكيل أن الشحنة 8842 متأخرة يومين. هذا صحيح. لكن التتبع يوضح أنه لم يستدعِ نظام التتبع المباشر أبدًا. بل قام بتجميع الإجابة من صفحة ويكي قديمة. في الأسبوع القادم، سيكون نفس المسار خاطئًا، ولن تكون اختباراتك قد حذرتك.
مثال عملي: تتبع واحد، وحكم واحد
تحتاج إلى شيئين هنا. الأول هو التتبع: يتم تسجيل كل خطوة كسجل خاص بها، مع المدخلات والمخرجات، باستخدام أداة مثل Langfuse أو Weave. الثاني هو مجموعة من الفحوصات الدقيقة التي تعمل على تلك السجلات. أدناه تتبع مبسط وتوضيحي لعملية الخصم المكرر من المقدمة. ويستخدم تخطيط الحقول الذي تلتقطه معظم أدوات التتبع.
</>View technical implementation · عرض التفاصيل التقنية
trace_id: tr_8f21  run_date: 2026-10-16  workflow: billing_dispute

span 1  llm.classify
  input:  "I was charged twice last Tuesday, card ending 4417"
  output: {"intent": "duplicate_charge", "confidence": 0.93}

span 2  tool.get_transactions
  args:   {"customer_id": "C-20931",
           "start_date": "2025-10-13",
           "end_date":   "2025-10-13"}
  status: 200   latency_ms: 212
  result: []

span 3  llm.decide
  output: "No transactions found. No duplicate charge exists."

span 4  llm.reply
  output: "I've checked your account and found no duplicate
           charge on that date. Is there anything else?"
كل فترة (span) أعادت نجاحًا. الرد مهذب ويتناسب مع النتيجة الفارغة التي حصل عليها. مقيّم الإجابة النهائية سيمررها بنجاح. الخطأ الفعلي يكمن في الفترة 2: السنة خاطئة بفارق عام واحد.
هناك فحصان يكتشفان ذلك، ويعملان بالتسلسل.
فحص حتمي أولاً. كود برمجي عادي، بدون ذكاء اصطناعي. إذا استخدم استدعاء الأداة مُعامل تاريخ وأرجع نتيجة فارغة، وكان ذلك التاريخ يبعد أكثر من 30 يومًا عن تاريخ التشغيل، فقم بوضع علامة على هذه الفترة. هذا الفحص رخيص، وفوري، ولا يحتاج إلى تقييم ذكي.
ثم حكم موجّه. الحكم هو نموذج ثانٍ يقيّم خطوة واحدة مقابل سؤال واحد. إنه لا يقيّم المحادثة بأكملها. يبدو الموجّه (prompt) هكذا:
</>View technical implementation · عرض التفاصيل التقنية
You are checking one tool call. Do not judge the final reply.

User message: {user_message}
Run date: {run_date}
Tool call: {tool_name}({tool_args})

Question: Are the date arguments consistent with the dates the
user referred to, relative to the run date?

Respond in JSON:
{"verdict": "PASS" | "FAIL", "expected": "...", "reason": "<one sentence>"}
في هذا التتبع، يُرجع الحكم:
</>View technical implementation · عرض التفاصيل التقنية
{"verdict": "FAIL",
 "expected": "start_date 2026-10-13, end_date 2026-10-13",
 "reason": "User said 'last Tuesday' on 2026-10-16; arguments use 2025."}
الإصلاح الآن واضح وبسيط. احسب التواريخ النسبية في الكود قبل أن يراها الوكيل، ومرر التاريخ المطلق. بدون التتبع، يظهر نفس الخطأ البرمجي كزيادة بطيئة في شكاوى "الوكيل لم يتمكن من العثور على معاملتي". ثم يقضي شخص ما أيامًا في مراجعة السجلات.
موجهات التقييم (judge prompts) التي تؤدي معظم العمل يستهدف كل منها فشلًا واحدًا:
- ▸اختيار الأداة: "بناءً على الطلب وهذه الأدوات المتاحة، هل كانت هذه الأداة الصحيحة؟ PASS أو FAIL، مع جملة واحدة."
- ▸تأصيل المعاملات: "هل كل مُعامل مأخوذ إما من رسالة المستخدم، أو من نتيجة أداة سابقة، أو من قيمة افتراضية منصوص عليها؟" هذا يكتشف المعرفات والتواريخ المختلقة.
- ▸تفسير النتيجة: "هل الخطوة التالية للوكيل تتبع ما أرجعته الأداة؟" هذا يكتشف الوكيل الذي يقرأ نتيجة فارغة على أنها "لا" مؤكدة.
- ▸إنهاء الحلقة: "هل توقف الوكيل بمجرد حصوله على معلومات كافية، أم قام باستدعاء متكرر؟"
الأسئلة الدقيقة والمحددة تحصل على إجابات يمكنك الاعتماد عليها. سؤال "هل كانت هذه العملية جيدة؟" سيجلب لك حكمًا بمزاج جيد فقط.
حلقات إعادة المحاولة هي حيث تخرج التكلفة عن السيطرة
هناك فشل واحد يستحق ضابطًا خاصًا به. يرسل الوكيل طلبًا مشوهًا، ويتلقى خطأً، ويحاول مرة أخرى. تضيف معظم الإعدادات المحاولة الفاشلة إلى الذاكرة العاملة للوكيل، حتى يعرف النموذج ما الذي جربه. هذا يجعل كل إعادة محاولة أكبر حجمًا من سابقتها.
كل إعادة محاولة تعيد إرسال السياق بأكمله بالإضافة إلى كل خطأ سابق، لذلك تنمو رموز الإدخال (input tokens) بشكل أسرع من عدد مرات إعادة المحاولة. عملية واحدة عالقة يمكن أن تكلف بقدر مئات العمليات العادية، ومقال ما تفعله إعادات المحاولة بفاتورة الـ API يحتوي على الحسبة الرياضية.
الضابط هنا ليس موجّهًا (prompt) أذكى. بل هو حد أقصى صارم لإعادات المحاولة لكل أداة. الخطأ المتطابق المتكرر ينهي العملية أيضًا ويسلمها إلى شخص حقيقي. تخبرك تتبعاتك بعد ذلك بالأداة التي تستمر في تجاوز الحد الأقصى. لمعرفة كيفية تصميم عمليات التسليم هذه، راجع أنماط إنتاج LangGraph الخاصة بنا.
بوابات التغيير في CI، وأخذ عينات من بيئة الإنتاج ليليًا
يعمل التقييم في مكانين. وأنت بحاجة إليهما معًا.
قبل الإصدار: بوابة CI. يقوم التكامل المستمر (CI) بتشغيل اختبارات آلية في كل مرة يقترح فيها شخص ما تغييرًا. أي تغيير في موجّه، أو نموذج، أو وصف أداة، أو الرسم البياني (graph) يجب أن يؤدي إلى تشغيلها. يتم تشغيلها مقابل مجموعة بيانات ذهبية: 100 إلى 500 مدخل حقيقي، كل منها مقترن بالأدوات التي يجب استدعاؤها وما يُعد نجاحًا. قم بتضمين الحالات المتطرفة، والمدخلات العدائية، والطلبات متعددة الخطوات التي تسببت في أعطال من قبل. يعكس هذا النهج مجموعة اختبار الـ 100 سؤال التي نستخدمها لـ RAG، مع استدعاءات الأدوات المتوقعة بدلاً من الاستشهادات المتوقعة.
تقارن البوابة التغيير مع إصدار الإنتاج الحالي، خطوة بخطوة. إصلاح معالجة الفواتير الذي يُسقط تصنيف العقود بأربع نقاط لا يتم دمجه. بدون هذه البوابة، ستكتشف هذا التراجع عندما يشتكي أحد العملاء. كما أنها تغير طريقة عمل فريقك: يتوقف المهندسون عن الخوف من تعديل الموجهات (prompts).
بعد الإصدار: تقييم عينات الإنتاج. لا تقم بتقييم كل عملية. قيّم عينة عشوائية لتتبع الصحة العامة، وأضف كل عملية تتطابق مع فلتر المخاطر: أي خطأ في الأداة، أي عملية تتجاوز الحد الزمني، أي عملية تصل إلى الحد الأقصى لإعادة المحاولة، أي نتيجة أداة فارغة. العمليات المفلترة حسب المخاطر هي مصدر معظم اكتشافاتك المفيدة.
| أين | أي العمليات | ماذا تكتشف | ماذا يحدث عند الفشل |
|---|---|---|---|
| CI، عند كل تغيير | مجموعة البيانات الذهبية، الفحوصات الحتمية، حكام الخطوات، مقارنة بالأساس | التراجعات الناتجة عن تغييرات الموجهات أو النماذج أو الأدوات | يتم حظر الدمج |
| بيئة الإنتاج، كل عملية | التحقق من المخطط (Schema validation)، حدود إعادة المحاولة، العلامات الحتمية | الاستدعاءات المشوهة، الحلقات الخارجة عن السيطرة | إيقاف العملية أو تسليمها لشخص |
| بيئة الإنتاج، عينة ليلية | حكام الخطوات على عينة عشوائية بالإضافة إلى العمليات المفلترة حسب المخاطر | أخطاء الأدوات الصامتة، اختيار الأداة الخاطئة، الانحراف (drift) | فتح تذكرة، إضافة العملية إلى مجموعة البيانات الذهبية |
العمود الأخير من الصف السفلي هو ما يجعل هذا النظام يتحسن بمرور الوقت. كل فشل حقيقي يتم اكتشافه في بيئة الإنتاج يصبح حالة اختبار دائمة في CI.
تكلفة التقييم
غالبًا ما يتردد القادة في فكرة استخدام الذكاء الاصطناعي للتحقق من الذكاء الاصطناعي. لكن الحسبة الرياضية مطمئنة بمجرد تدوينها.
رموز الحكم اليومية (judge tokens) = العمليات يوميًا × معدل العينة × الخطوات المقيمة لكل عملية × الرموز لكل تقييم
لنفترض أنك تُشغل 10,000 مسار عمل يوميًا، وتأخذ عينة بنسبة 10%، وتقيّم 4 خطوات لكل عملية، وكل تقييم يستهلك حوالي 500 رمز (token). هذا يعني 2 مليون رمز حكم يوميًا. اضرب ذلك في سعر نموذج الحكم الخاص بك لكل مليون رمز. النماذج الصغيرة والسريعة من العائلات الرئيسية مناسبة تمامًا لفحوصات دقيقة كهذه. بأسعارها المعتادة، يتراوح الإجمالي اليومي عادة بين بضعة سنتات وبضعة دولارات.
التكاليف الأكبر تكمن في مكان آخر. بناء مجموعة البيانات الذهبية يستغرق وقتًا فعليًا من الموظفين. تخزين التتبعات يكلف مالاً عند الأحجام الكبيرة. يجب على شخص ما مراجعة العمليات المميزة بعلامات (flagged) كل أسبوع. ضع ميزانية لوقت المراجعة هذا. بدونه، تصبح لوحة التحكم مجرد زينة.
بالنسبة للحكم، استخدم عائلة نماذج مختلفة عن تلك التي تُشغل الوكيل. تميل النماذج إلى الموافقة على الاستنتاج الذي يشبه استنتاجها، وهو ما يسميه Zheng وآخرون بتحيز التعزيز الذاتي. حكم منفصل، بموجّه دقيق، يمنحك فحصًا أكثر استقلالية. كل بضعة أسابيع، قم بفحص عينة من أحكام التقييم يدويًا. الحكم الذي انحرف (drifted) أسوأ من عدم وجود حكم على الإطلاق.
ما يظهره لك التتبع عادةً لإصلاحه
الفرق التي تبدأ في التتبع تميل إلى اكتشاف نفس الشيء أولاً. الوكيل لديه خيارات أكثر من اللازم. أعطِ النموذج عشرين أداة وتعليمة "استخدم حكمك"، وسوف يخلط بين الأدوات ذات الأسماء المتشابهة ويخترع مدخلات.
الإصلاح الهيكلي هو التوجيه (routing) أولاً ثم الحد من الأدوات. صنّف الطلب مقدمًا. أرسل طلب استرداد الأموال إلى مسار عمل فرعي للاسترداد لا يمكنه الوصول إلا إلى الأداتين أو الثلاث أدوات التي يحتاجها الاسترداد. خطوات أقل ترفع p أس n بشكل مباشر. أدوات أقل تقلل من عدد الخيارات الخاطئة المتاحة. مقدار ما يوفره هذا يعتمد على مدى تشتت وكيلك الحالي، وتتبعاتك ستخبرك بهذا الرقم الدقيق. قد يتعامل وكلاؤك مع الطلبات الواردة التي تحتاج إلى قواعد حول من يُسمح له بالرد وما يمكن إرساله للعملاء. تم بناء Verel Coordinator لطبقة التوجيه هذه.
القيود على ما يمكن للوكيل القيام به تجعل التقييم أكثر موثوقية أيضًا. عندما يكون لدى الوكيل مجموعة صغيرة ومحددة من الخيارات، تكون الإجابة الصحيحة لكل خطوة واضحة وتصبح مهمة الحكم أسهل. التعليمات على مستوى الموجّه (prompt) وحدها لن تحافظ على هذه القيود تحت ضغط حركة المرور الحقيقية.
→ تقييم نظام RAG قبل الإطلاق: مجموعة اختبار من 100 سؤال وأربعة مقاييس للقبول → عندما يخطئ وكيل الذكاء الاصطناعي: أنماط الفشل والضوابط التي تحتويها → لماذا تفشل وكلاء الذكاء الاصطناعي في طبقة واجهة برمجة التطبيقات (API): سبعة إخفاقات صامتة وضابط لكل منهاالأسئلة الشائعة
هل يؤدي التتبع أو التقييم إلى إبطاء استجابة المستخدم؟ لا، إذا تم إعداده بشكل صحيح. ترسل أدوات التتبع سجلاتها في الخلفية، بشكل منفصل عن الرد. يعمل الحكام لاحقًا على التتبعات المخزنة، لذلك لا ينتظرهم المستخدم أبدًا. الفحوصات الوحيدة التي تعمل بشكل متزامن (inline) هي فحوصات الكود السريعة، مثل التحقق من صحة مدخلات الأداة وفرض حدود إعادة المحاولة.
ماذا يجب أن نفعل عندما يُفشّل الحكم خطوة ولكن الإجابة النهائية كانت صحيحة؟ تعامل معها كاكتشاف حقيقي. هذا يعني عادةً أن الوكيل تعافى بالحظ أو بعد محاولات إعادة مهدرة. كلاهما يكلف مالاً، والحظ ينفد مع مدخلات مختلفة قليلاً. قم بإصلاح وصف الأداة أو معالجة المدخلات، ثم أضف تلك العملية إلى مجموعة البيانات الذهبية الخاصة بك.
لماذا لا نكتب فقط اختبارات الوحدة (unit tests) لأدواتنا؟ اكتبها، لأنها تؤكد أن الأداة تعمل عندما تتلقى مدخلات صحيحة. لكنها لا تستطيع إخبارك ما إذا كان الوكيل يختار الأداة الصحيحة، أو ينتج مدخلات صحيحة من رسالة عميل فوضوية. تقييم المسار يختبر قرارات الوكيل. بينما تتحقق اختبارات الوحدة من الكود الأساسي.
هذا الأسبوع: ابدأ ببوابة CI
إذا لم يكن لديك تقييمات للمسار ولا مجموعة بيانات ذهبية اليوم، فابدأ ببوابة CI على مجموعة بيانات ذهبية مكونة من 100 حالة. اسحب 100 طلب حقيقي من سجلات الشهر الماضي، بما في ذلك الطلبات التي حدثت بها أخطاء. لكل منها، اكتب الأداة التي كان ينبغي استدعاؤها وبأي معاملات (arguments). قم بتشغيل الوكيل الحالي عليها واحسب الأخطاء. هذا الرقم هو خط الأساس الخاص بك، وكل تغيير في الموجّه (prompt) من الآن فصاعدًا يجب أن يتفوق عليه.