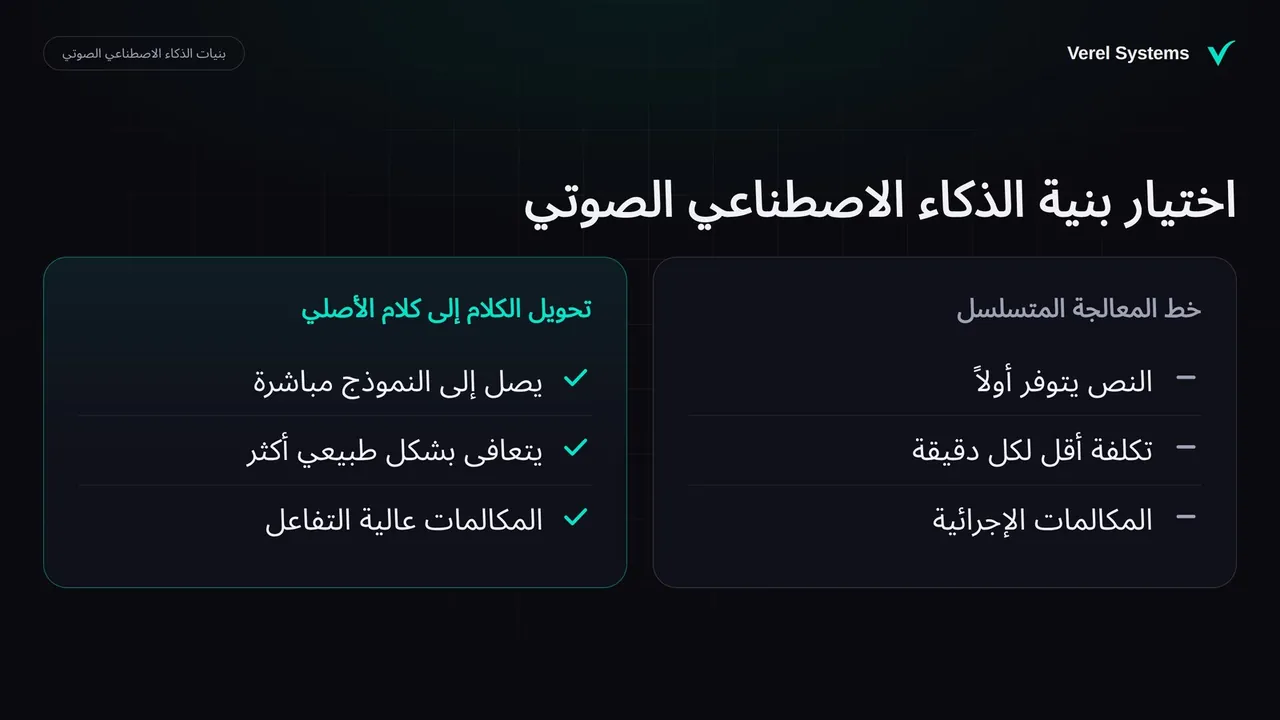
تحويل الكلام إلى كلام أم النظام المتسلسل (Cascade)؟ اختيار بنية الذكاء الاصطناعي الصوتي لكل نوع مكالمة
نماذج تحويل الكلام إلى كلام تستجيب بشكل أسرع وتلتقط نبرة الصوت. بينما الأنظمة المتسلسلة (Cascades) أرخص، وأسهل في التدقيق، وأكثر أماناً للتحقق. إليك كيفية الاختيار بناءً على نوع المكالمة، مع معادلة نقطة التعادل.
لم يعد السؤال اليوم عما إذا كان الذكاء الاصطناعي الصوتي يعمل أم لا. القرار الآن هو أي نوع ستبني. هذا الاختيار يحدد تكلفتك لكل مكالمة، ومسار التدقيق، وكيفية تعامل النظام مع نبرة الصوت.
يوجد تصميمان في السوق. خط المعالجة المتسلسل (cascaded pipeline) يربط ثلاثة أنظمة. الأول يحول الكلام إلى نص، ثم يكتب النموذج اللغوي الرد، والثالث يحول الرد إلى كلام. أما النموذج الأصلي لتحويل الكلام إلى كلام (native speech-to-speech model) فيستقبل الصوت ويرسل الصوت مباشرة، دون أي خطوة نصية في المنتصف. عائلات النماذج مثل GPT و Gemini تقدم الآن أوضاعاً صوتية في الوقت الفعلي من هذا النوع. وكلاهما مشروح في وثائق OpenAI Realtime API و وثائق Gemini Live API.
لا توجد تقنية أفضل بشكل عام. كل واحدة منهما هي الخيار الأفضل لنوع معين من المكالمات.
لماذا يعتبر زمن الاستجابة أول ما يلاحظه المتصلون
أثبتت أبحاث المحادثات أن الفجوة المعتادة بين المتحدثين تبلغ حوالي 200 مللي ثانية. هذا النمط ثابت عبر اللغات (Stivers et al., PNAS, 2009). المتصلون لا يملكون ساعة توقيت، لكنهم يشعرون بالتأخير. بمجرد أن تتجاوز فترة الصمت نصف ثانية بكثير، يبدأ الناس في التحدث فوق الوكيل (agent)، أو تكرار كلامهم، أو طلب التحدث مع موظف بشري.
خط المعالجة المتسلسل يحتوي على خطوات أكثر، وكل خطوة تضيف تأخيراً. أولاً، يجب على النظام أن يقرر أن المتصل قد انتهى من الحديث. يُعرف هذا بتحديد نقطة النهاية (endpointing). إذا ضبطته بشكل ضيق جداً، فسيقاطع الناس. وإذا ضبطته بشكل فضفاض، فستبدأ كل استجابة بصمت تام. بعد ذلك يأتي التفريغ الصوتي، ثم الكلمات الأولى التي ينتجها النموذج، ثم توليد الصوت، وأخيراً رحلة الشبكة للعودة إلى خط الهاتف.
الأنظمة المتسلسلة المصممة جيداً لا يزال بإمكانها الاستجابة في أقل من 500 مللي ثانية. نغطي كيفية القيام بذلك في دليل زمن الاستجابة الخاص بنا. لكن هذا العمل يتطلب جهداً، وتبقى المقاطعات هي نقطة الضعف. إذا قاطع المتصل قائلاً "لحظة، عنواني تغير"، يجب على النظام المتسلسل أن يلاحظ ذلك، ويوقف الإخراج الصوتي، ويعيد التخطيط. إذا تم ذلك بشكل سيء، سيستمر الوكيل في التحدث فوق المتصل. المقاطعة (Barge-in) ومشكلة الذاكرة التي تخلقها تعتبر بحد ذاتها حالة فشل مستقلة.
النماذج الأصلية تزيل عمليتي التسليم النصي. وهي تميل إلى الاستجابة بشكل أسرع والتعافي من المقاطعات بشكل طبيعي أكثر. الفجوة حقيقية، لكنها أصغر مما توحي به العروض التوضيحية للشركات بمجرد أن تصبح شبكتك والأنظمة الخلفية جزءاً من المسار.
ما يفقده النص: نبرة الصوت
تخيل مريضاً يقول "ممتاز" بنبرة محبطة بعد سماعه أن الموعد المتاح القادم بعد ثلاثة أسابيع. معظم أنظمة التفريغ الصوتي ستخرج كلمة "ممتاز" فقط. إذا لم يكن هناك شيء آخر في خط المعالجة يتتبع نبرة الصوت، فقد يتعامل النموذج اللغوي معها على أنها موافقة ويرد ببهجة.
النماذج الأصلية تعمل على الصوت نفسه، لذا فإن طبقة الصوت، والسرعة، والتردد تصل إلى النموذج مباشرة. هذا يمكن أن يساعد في تهدئة الموقف: حيث يبطئ الوكيل من سرعته، ويلطف رده، أو يعرض التحدث إلى موظف بشري في وقت أقرب. في المكالمات التي يؤدي فيها الإحباط إلى التصعيد، هذا الأمر مهم. أما في مكالمة تؤكد فقط موعد التوصيل، فلا يهم ذلك على الإطلاق.
في البيئات الخاضعة للتنظيم مثل الرعاية الصحية والتمويل، قم بإعداد تفريغ نصي منفصل لكل مكالمة تستخدم نموذجاً أصلياً. سجل البث الصوتي وأرسله إلى خدمة تفريغ صوتي بالتوازي، ثم اكتب النص في نظام إدارة علاقات العملاء (CRM) الخاص بك بعد المكالمة. المحادثة من صوت إلى صوت لا تترك سجلاً نصياً قابلاً للبحث بشكل افتراضي، وفريق الامتثال لديك سيحتاج إلى واحد.
ما يمنحك إياه النص: التحكم
نادراً ما تظهر هذه المقايضة في مقارنات الشركات. في النظام المتسلسل، يكون الرد موجوداً كنص قبل أن يسمعه أي شخص. يمكن لنظامك التحقق من هذا النص أولاً: حظر وعد باسترداد الأموال، أو ادعاء طبي، أو رقم لا ينبغي للوكيل ذكره. تعليمات الموجّه (prompt) وحدها لا تصمد أمام حركة المرور الحقيقية، كما يشرح مقال لماذا تفشل تعليمات الموجّه وحدها في بيئة الإنتاج. بينما التحقق من المخرجات يفي بالغرض.
مع النموذج الأصلي، يتم إنتاج الصوت مباشرة. بعض الخدمات تبث نسخة نصية جنباً إلى جنب مع الصوت، لكنها تصل في نفس اللحظة، لذا فإن أي فحص يتم بالتوازي، وليس مسبقاً. بحلول الوقت الذي يتم فيه الإبلاغ عن انتهاك، يكون المتصل قد سمعه غالباً.
إذا كانت مكالماتك تتضمن عبارات خاضعة للتنظيم، فهذا وحده يمكن أن يحسم الاختيار.
التكلفة: احسب المعادلة بأسعارك الخاصة
يتم تسعير الصوت الأصلي لكل رمز صوتي أو لكل دقيقة. في صفحات تسعير OpenAI و Gemini، يكلف الأمر في الدقيقة أكثر من النظام المتسلسل الذي يستخدم مزودين منفصلين للتفريغ والنص والصوت، بمجرد تحويل الرموز إلى دقائق. الأسعار تتغير باستمرار، لذا احصل على عروض أسعار حالية لحجم عملك بدلاً من الوثوق بأي جدول في مدونة، بما في ذلك مدونتنا.
السؤال المفيد ليس أيهما يكلف أقل. بل ما إذا كانت التكلفة الإضافية للنموذج الأصلي تعوض قيمتها. استخدم أرقامك الخاصة.
- ▸P = تكلفة النموذج الأصلي في الدقيقة ناقص تكلفة النظام المتسلسل في الدقيقة
- ▸L = متوسط طول المكالمة بالدقائق
- ▸H = التكلفة الإجمالية لتحويل مكالمة واحدة لموظف بشري
- ▸التكلفة الإضافية لكل مكالمة = P × L
- ▸نقطة التعادل = يجب أن يمنع النموذج الأصلي تحويلاً واحداً كل H ÷ (P × L) مكالمة
لنفترض أن التكلفة الإضافية لكل مكالمة هي عُشر تكلفة التحويل لموظف بشري. إذن، النموذج الأصلي يعوض قيمته إذا منع تصعيداً واحداً في كل عشر مكالمات. حافظ على اتساق الوحدات. يتم حساب التحويلات لكل مكالمة، وليس لكل دقيقة من وقت التحدث.
قس هذا قبل أن تلتزم. قم بتشغيل كلا التصميمين على شريحة من حركة المرور الحقيقية وقارن معدلات التصعيد. لا تعتمد على عرض توضيحي من شركة أو مشروع تجريبي يديره أكثر المختبرين صبراً لديك.
جدول اتخاذ القرار
| العامل | النظام المتسلسل (تحويل الكلام لنص، النموذج، تحويل النص لكلام) | النموذج الأصلي لتحويل الكلام إلى كلام |
|---|---|---|
| سرعة الاستجابة | أقل من 500 مللي ثانية ممكن، لكنه يتطلب هندسة | عادة أسرع؛ لكن الشبكة واستدعاء الأدوات لا تزال تضيف تأخيراً |
| المقاطعات | أضعف؛ يعتمد على ضبط نقطة النهاية | يتعافى بشكل طبيعي أكثر |
| نبرة الصوت والعاطفة | تُفقد ما لم تضف طبقة منفصلة لنبرة الصوت | تصل إلى النموذج مباشرة |
| التحقق من الردود قبل نطقها | نعم، النص موجود أولاً | عادة بالتوازي فقط، بعد حدوث الأمر |
| تفريغ التدقيق | يُنتج كجزء من خط المعالجة | يجب بناؤه كعملية منفصلة |
| اللهجات الخليجية العربية | يمكن استخدام تفريغ صوتي مضبوط للهجات وأصوات عربية | عادة أضعف اليوم؛ اختبره على مكالمات حقيقية |
| التكلفة في الدقيقة | أقل بشكل عام | أعلى بشكل عام؛ تحقق من الأسعار الحالية |
| الأنسب لـ | المكالمات الإجرائية ذات الحجم الكبير | المكالمات الحساسة حيث تحدد نبرة الصوت النتيجة |
التقسيم الناجح
استخدم النظام المتسلسل للمكالمات الإجرائية. تأكيدات المواعيد، وحالة الطلب، والتأهيل الأساسي للعملاء المحتملين، والإرسال تتبع نمطاً خطياً من الأسئلة والأجوبة. نادراً ما تغير نبرة الصوت النتيجة. التكلفة الأقل في الدقيقة والقدرة على التحقق من الردود أولاً تشكل فارقاً مع الحجم الكبير.
استخدم النموذج الأصلي للمكالمات الحساسة. فرز الدعم، ومحادثات التحصيل الحساسة، وخطوط الكونسيرج المميزة هي الأماكن التي يقرر فيها الإحباط والمقاطعات وسرعة التحدث ما إذا كان المتصل سيبقى على الخط. هناك، قد تستحق التكلفة الإضافية الدفع. تحقق من ذلك باستخدام المعادلة أعلاه.
العديد من العمليات تحتاج إلى كليهما. خطوة تصنيف قصيرة في بداية المكالمة يمكن أن توجه كل متصل إلى التصميم الصحيح. هذا يتطلب هندسة أكثر من نظام واحد، لذا قم ببنائه فقط عندما يكون مزيج مكالماتك مقسماً بوضوح.
أياً كان اختيارك، غالباً ما تكون الأنظمة الخلفية أكثر أهمية من النموذج. إذا كان البحث عن موعد أو مخزون يستغرق معظم الثانية للرد، فسيسمع المتصل صمتاً. النموذج الصوتي السريع لا يحل هذه المشكلة. تخطي هذا التحقق يعني الدفع مقابل صوت منخفض زمن الاستجابة مع الاستمرار في تقديم تأخير.
الأسئلة الشائعة
هل تتعامل النماذج الأصلية لتحويل الكلام إلى كلام مع اللهجة الخليجية بشكل أفضل من الأنظمة المتسلسلة؟ غالباً لا، في الوقت الحالي. يتم تدريب النماذج الأصلية في الغالب على اللغة الإنجليزية واللغات المنطوقة على نطاق واسع. وتميل إلى أن تكون أضعف في اللهجات الخليجية وفي التبديل اللغوي بين العربية والإنجليزية. النظام المتسلسل يتيح لك اختيار خدمة التفريغ الصوتي التي تؤدي بشكل أفضل مع لهجتك وصوتاً عربياً يبدو طبيعياً. راجع اختيار محرك التفريغ الصوتي الأفضل للهجتك. اختبر أي نموذج أصلي على تسجيلات لمتصليك قبل أن تلتزم.
هل يمكننا البدء بنظام متسلسل والتبديل إلى النموذج الأصلي لاحقاً؟ نعم، ولكن خطط لإعادة عمل حقيقية. النظام المتسلسل يدير المحادثة واستدعاء الأدوات كنص. بينما تدمج النماذج الأصلية استدعاء الأدوات في بث صوتي مباشر. يجب أن تتعامل الأنظمة الخلفية لديك مع عمليات البحث دون حظر الصوت. حافظ على منطق الأعمال وطبقة الأدوات منفصلة عن الطبقة الصوتية منذ البداية، وسيصبح التبديل تغييراً محدوداً ومحتوى.
ما الذي يسبب أكبر قدر من التأخير، بغض النظر عن النموذج؟ المسافة وعمليات البحث البطيئة. لنفترض أن النموذج يعمل في الولايات المتحدة، وقاعدة البيانات في أوروبا، والمتصل في دبي. كل رحلة ذهاب وإياب تضيف تأخيراً لا يمكن لأي نموذج إزالته. قم باستضافة خوادم الاستنتاج، وقواعد البيانات التي يستدعيها الوكيل، وبوابة الهاتف أو WebRTC في نفس المنطقة.
قم بتشغيل كلا التصميمين على 100 مكالمة من نوع واحد، وسجل معدل التصعيد ووقت الاستجابة p95 لكل منهما، وأدخل الفرق في معادلة نقطة التعادل.
→ زمن الاستجابة في الذكاء الاصطناعي الصوتي: كيف تبني خط معالجة تدفقي يجيب في أقل من 500 مللي ثانية → أنماط فشل Voice AI في بيئة الإنتاج: زمن الاستجابة، المقاطعة، الصمت، والتبديل اللغوي → لماذا تفشل حواجز الحماية للموجّهات (Prompt Guardrails) في بيئة الإنتاج، وما الذي يفعله فحص المخرجات بدلاً من ذلك